Signal
📡 Signal|Microsoft、2027年から推論の主力を自社チップ Maia に
Microsoft は自社設計の AI 半導体 Maia を2027年から数ギガワット規模で展開し、自社サービスの推論の主力にすると発表した。第3世代の Maia 300 は電力あたりの処理量で GPU 比40%増を見込む。
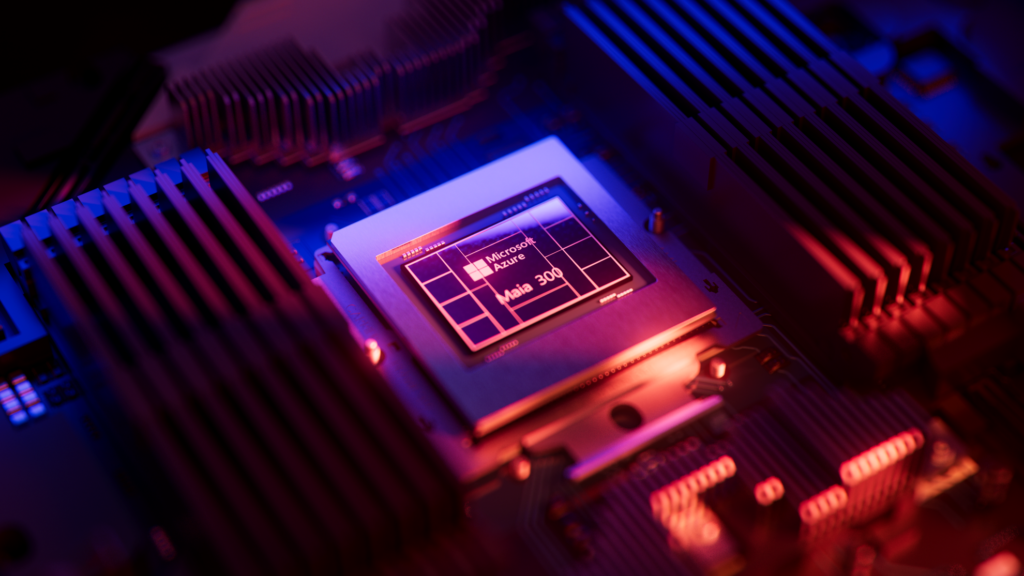
Microsoft は10月12日、自社で設計する AI 半導体 Maia を2027年から数ギガワット規模で展開し、自社の製品とサービスの推論を担う主力のシステムにすると発表した。あわせて第3世代の Maia 300 を公表し、電力1メガワットあたりで処理できるトークンの量が、主流の GPU を使うシステムより40%多くなる見込みだと示した。
AI の計算基盤を測る単位が、チップの枚数から電力のギガワットへ移っている。同じ電力でどれだけの推論をこなせるかが費用を決める段階で、最大級のクラウド事業者が自社の推論を自前のチップに寄せると明言したことになる。
発表の中身: 2027年から数ギガワット、推論の主力に
発表は、クラウドと AI の事業を率いる Scott Guthrie 氏の名で公式ブログに出た。同じ日に CEO の Satya Nadella 氏も X で「自社のシリコンへのこれまでで最大の賭け」と告知している。
現行の Maia 200 は、すでに本番の処理を担っている。
- いま動いている用途 — Microsoft Copilot と、自社モデルを開発する MAI チームの処理
- 2026年末までに加わる用途 — GitHub Copilot と、企業向けの AI 開発基盤 Microsoft Foundry
- 動かしているモデル — OpenAI のモデル、自社の MAI モデル、主要なオープンソースのモデル
- 展開先 — 米国、欧州、オーストラリア
同社によれば、Teams や Copilot に組み込んだ AI の機能では、主流の GPU の設備と比べて電力1ワットあたり最大1.7倍のトークンを処理している。2027年からはこの系統を数ギガワットの規模に広げ、自社の製品とサービスの推論の主力に据える。
Maia 300 の設計: 学習より推論を先に置いた
Maia 300 は推論を優先して設計した第3世代のチップだ。公式ブログと、同日に出た技術解説の記事から主な仕様を拾う。
- 演算部分は TSMC の N2P の工程で作る。演算、メモリの制御、入出力を別々のチップに分けて組み合わせる
- 広帯域メモリ HBM4 を8つ積み、容量は288GB、帯域は毎秒18TB。消費電力の設計値は950ワット
- 1つのラックに96個を載せ、ラック全体の電力は167キロワット。メモリはラックで27.6TB
- ラックをまたいで最大1万2,288個を一つのまとまりとしてつなげる
- 前の世代の Maia 200 と比べ、電力あたりの性能は2.5倍超、96個を載せたラック全体のトークン処理量は最大7倍
精度を落とした数値の形式 (MXFP4) を使い、計算と、会話の文脈を保持するメモリの両方で必要な容量と帯域を減らす。答えを返す推論では、学習ほどの精度を要さない計算が多く、そこを電力の節約に変える設計だ。本番への配備は2027年に始まる。
なお、40%という GPU との差も、前世代との倍率も、まだ量産前のチップについての同社自身の見込みであり、外部の検証を経た数字ではない。
推論の費用を誰が握るか
大手のクラウド事業者が自前のチップを持つ流れは、Microsoft が最初ではない。Google には TPU が、Amazon には Trainium がある。Microsoft は2023年11月に初代の Maia を発表しており、今回の発表はその系統を「数ギガワット」という規模で前面に出す宣言にあたる。
意味を持つのは、AI の支出の重心が学習から推論へ移っている点にある。モデルを一度作る費用より、多くの利用者が毎日使う Copilot の応答を返し続ける費用のほうが、長い目で大きくなる。その費用は電力でほぼ決まる。データセンターに引ける電力に上限がある以上、1メガワットあたりのトークン量が4割違えば、同じ電力から引き出せるサービスの量が4割違う。
電力が計算の上限を決める構図は、AI の外側にも広がっている。ビットコインの採掘事業者が、確保済みの電力と用地を AI や高性能計算のデータセンターへ振り向ける動きも、同じ物差しの上にある。電力をどれだけ押さえ、それをどれだけ効率よく計算に変えられるかが、半導体の調達とインフラ投資の両方を動かす軸になった。
一方で、発表は GPU の調達をやめるとは言っていない。Microsoft が自社の推論を Maia に寄せても、外部の顧客に貸し出すクラウドの計算や、最先端のモデルの学習で GPU がどの程度残るかは、この発表からは読めない。
次に見るもの
確認先は、11月17〜20日にサンフランシスコで開く Microsoft Ignite 2026 だ。同社は Maia の戦略をそこで詳しく話すとしている。見るべき点は3つある。Maia 300 を外部の顧客にもクラウドで提供するのか、Maia で動かすモデルに OpenAI 以外の外部のモデルがどこまで加わるのか、そして2027年の「数ギガワット」が具体的にどの地域の何拠点を指すのかだ。
その前に、例年10月下旬に出る同社の7〜9月期の決算で、設備投資の額と、自社チップへの配分にどこまで触れるかも手がかりになる。
ことば
- 推論 — 学習を終えた AI のモデルが、質問に答えたり文章を作ったりする処理。利用者が増えるほど回数が増え、電力と費用がかさむため、専用のチップで効率を上げる競争が起きている。
- トークン — AI のモデルが文章を処理する単位で、語や語の一部にあたる。「1メガワットあたりのトークン量」は、同じ電力でどれだけの応答を返せるかを示す物差しとして使われる。
- HBM (広帯域メモリ) — 演算チップのすぐそばに積み重ねて置く高速のメモリ。AI の処理では計算の速さよりデータを運ぶ速さが詰まりやすく、HBM の容量と帯域が性能を左右する。
🔗 一次ソース
 Microsoft 公式ブログ「Microsoft to expand Azure Maia system to multi-gigawatt deployments」(2026年10月12日・Scott Guthrie 氏) — 2027年からの数ギガワット規模の展開、推論の主力化、Maia 200 の用途と展開地域、1ワットあたり最大1.7倍、Maia 300 の1メガワットあたり40%増と仕様を確認The Official Microsoft Blog
- Satya Nadella 氏の X の告知 (2026年10月12日)
 Azure 公式ブログ「Deep dive into Azure Maia 300 architecture」(2026年10月12日) — HBM4 の容量288GB、ラック96個・167キロワット、最大1万2,288個のまとまり、電力あたり性能2.5倍超、Ignite 2026 の日程を確認Microsoft Azure Blog


