Signal
📡 Signal|Gemini 4 Argon、長い企業業務とサイバー防御へ
GoogleがGemini 4 Argonを発表。長い企業業務とサイバー防御を軸に、評価ごとの競争、完成率、時間、費用、限定提供を検分する。
Google DeepMindは9月30日、Gemini 4 Argonを発表した。長い企業業務を継続する能力と、脆弱性を見つけて修正する能力を前面に出す。AI産業の競争を見る軸に、業務の完成まで任せられる範囲と、その費用が加わる。
 Google:Gemini 4 Argon発表、出力上限・社内利用・提供方針Google
出力100万トークンで長い仕事を継続
GoogleはArgonの出力上限を、従来の6万4000から100万トークンへ拡大した。トークンはAIが文章やコードを処理する単位だ。今回の数字は、読み込める資料量を示す入力の容量とは別で、長い推論や生成を続けるための上限を指す。
企業の仕事には、調査、修正、試験、再修正が何度も続く工程がある。途中で作業が切れるたびに人が状況を渡し直すなら、AIを導入しても引き継ぎの負担が残る。長い工程を保持できる能力は、この負担を減らす方向に働く。
Googleは社内で、大規模なコードの移行や最適化にArgonを使っていると説明する。同時に、重要なシステムの書き換えは、本番へ反映する前に自動・手動の監査、試験、レビューを行うとしている。生成を長く続けられることと、成果物をそのまま採用できることには、検証の工程がある。
業務評価で先行、コーディングは評価ごとに差
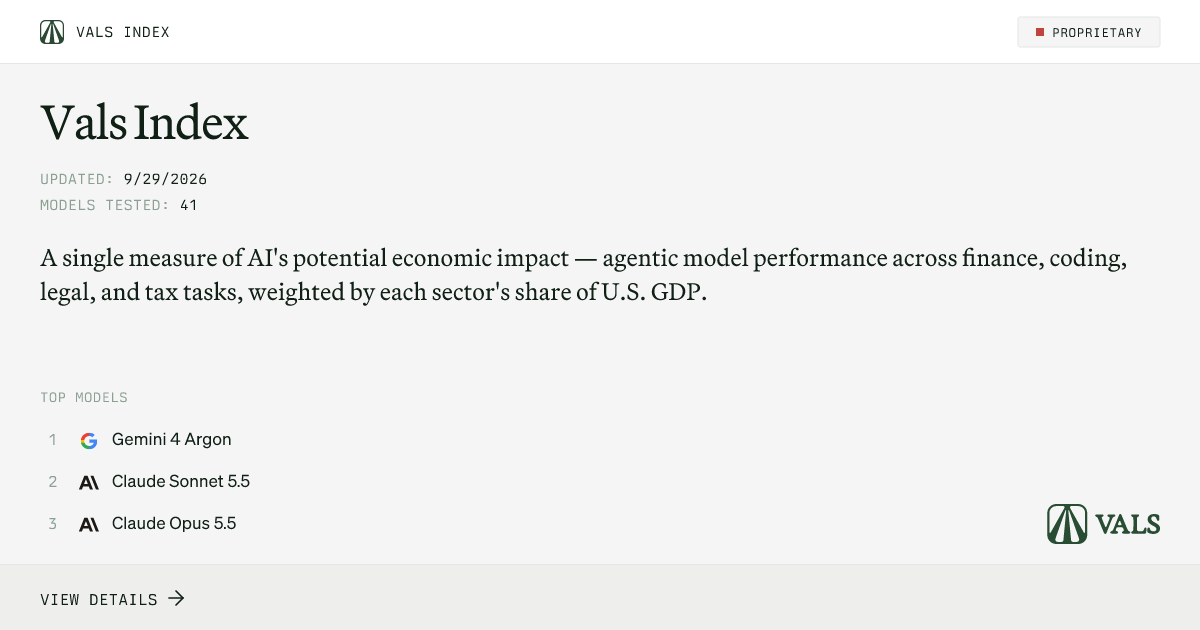
金融、コード、法務、税務の業務をまとめて測るVals Indexでは、運営元のVals AIがArgonの68.90%を掲載し、表の先頭に置いている。この指数は米国の各分野のGDP比率で重みを付けた性能指標だ。68.90%を、そのまま経済成長率や人員削減率へ読み替えることはできない。
Googleの公式比較表から、企業業務とコード関連の評価を抜き出すと、次のようになる。数字は各評価のスコアで、異なる行の数字を直接比較するものではない。
| 評価 | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Vals Index:複数分野の業務 | 68.9% | 63.1% | 67.0% |
| AutomationBench:業務の一連の実行 | 51.3% | 41.4% | 42.5% |
| DeepSWE v1.1:長いソフトウェア開発 | 77.9% | 74.1% | 74.2% |
| FrontierSWE v2:ソフトウェア開発 | 55.0% | 65.5% | 62.3% |
| Terminal-bench 4.0:端末を使う作業 | 57.4% | 58.2% | 66.4% |
Argonは業務の評価やDeepSWEで高いスコアを出す一方、FrontierSWEとTerminal-benchでは表内の競合を下回る。コーディング全般で一つのモデルが優位、というまとめ方では選定材料が落ちる。
評価条件にも差がある。Googleの方法論資料では、ArgonのDeepSWEとTerminal-benchは自社計測、競合の値は公開ランキングや各社の資料から取得したと説明する。企業の導入判断では、自社の資料、権限、道具を使った同じ課題で、完成率と人の修正時間を比較する必要がある。
サイバー防御は発見から修正まで
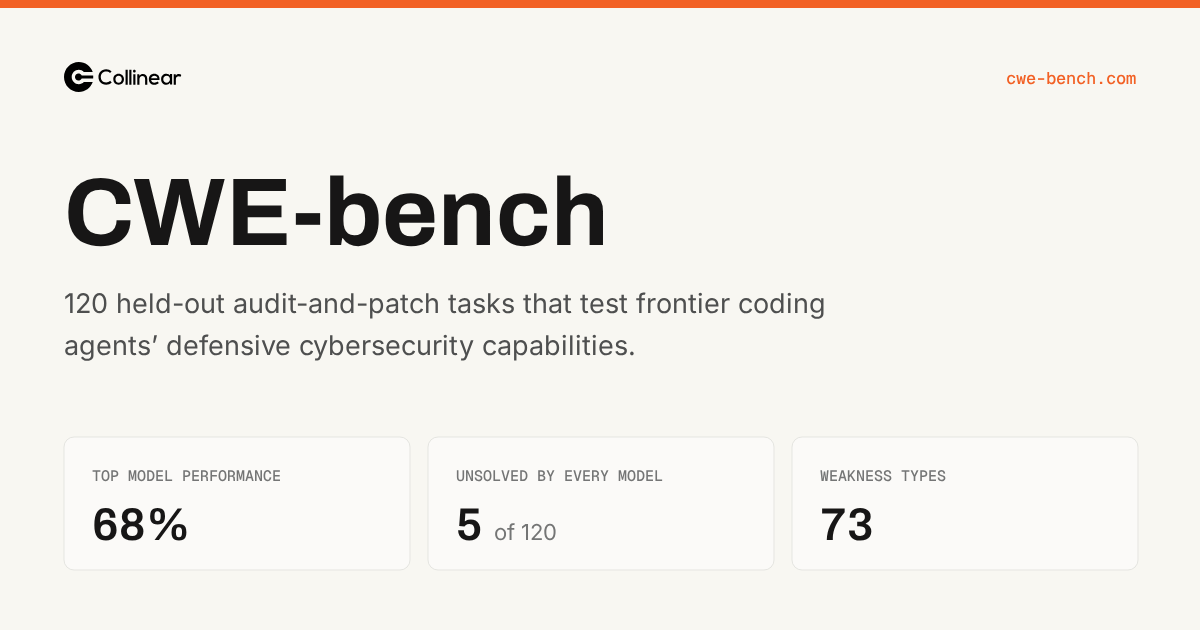
防御の評価を運営するCollinear AIのCWE-bench v1では、Argon、GPT-6 Astra、Grok 4.7が、プログラムによる判定のPass@1で68%の同率首位となっている。Pass@1は一度の実行で課題を解決できる割合だ。
この評価は、脆弱性を調べて修正する120課題で構成される。既存機能を壊さず修正できるかも判定する。実際の企業ネットワーク全体の安全性を保証する数字ではないが、発見だけで終わらず、修正まで進める能力を比較できる。
Googleは、一部の信頼された防御担当者にFairwind Programを通じてArgonを提供する。対象には政府、医療、通信、エネルギー、金融ネットワークなどの重要基盤を守る組織が含まれる。参加組織の審査、利用者の認証、アクセスの管理を求め、アクセス権の再配布や販売を認めない。
企業への含意は、セキュリティ担当者がAIの修正案を試験し、適用まで管理する仕事の重みが増すことだ。資産を守る能力として評価するなら、発見件数に加え、修正にかかった時間、誤検知、適用後の不具合まで測ることになる。
導入競争を測る完成率・費用・提供範囲
性能の順位と、運用上の順位は一致しない。Vals AIの表ではArgonの評価時間は46分33秒、GPT-6 Astraは27分48秒となっている。Argonが上回る精度にも、待ち時間との交換条件がある。これは同サイトの評価であり、自社の一件の仕事が同じ時間で終わるという見積もりではない。
CWE-bench v1でも、平均実行費用はArgonが6.63ドル、GPT-6 Astraが2.85ドル、Grok 4.7が2.75ドルと掲載されている。Pass@1が同じ68%でも、使う道具や生成量を含む一回の実行費用は異なる。単価だけで選ばず、再試行と人の確認を含めた完成一件あたりの費用を比べる理由がここにある。
Googleは今後、有料API利用者とGoogle AI Ultra加入者から提供を広げる方針を示すが、一般提供の具体的な日付は発表していない。現時点の限定提供と、企業が通常の調達で導入できる状態は区別して読む。
次の提供拡大が発表された時には、GoogleのArgon発表ページで利用対象と条件を確認し、Vals AIとCWE-benchの更新で、精度・時間・費用の変化を照合する。長い業務を完成まで進める能力が、検証の負担と合わせてどこまで採算に乗るか。それが企業向けAIの競争を測る具体的な焦点になる。
ことば
- AIエージェント:目標に沿って道具を使い、複数の工程を進めるAI。企業では、文章の出来に加えて、作業の完了、利用権限、失敗した時の復旧までを評価対象にする。
- Fairwind Program:Googleが信頼された組織へ防御用モデルへの早期アクセスを提供する枠組み。Argonを使える参加者は一部に限られ、通常の一般提供とは入口が異なる。
🔗 一次ソース